Estratégias e Performance (Lean, Toc, 6 Sigma)
Sumário executivoSupply chain data lake em resumo: Um data lake é um repositório onde os dados ficam armazenados em formato bruto, sem precisar de estruturação prévia, como acontece no data warehouse. Na supply chain, ele permite análises e decisões baseadas em dados. Porém, sem alinhamento entre pessoas, processos e negócio, o lago pode virar um data swamp, repleto de dados de pouco valor.
Certamente você já deve ter se deparado, nos últimos anos, com o termo “Data Lake” ou “Lago de Dados” que, independentemente de sua arquitetura tecnológica, é um repositório de dados onde os mesmos ficam armazenados, em seu formato bruto, para uso corporativo.
Em um “Data Lake” podemos armazenar dados como eles são/estão, sem ter a necessidade de estruturá-los (como em um Data Warehouse) e mesmo assim poder executar diferentes tipos de análise dos dados.
Olá pessoal, sejam bem-vindos a mais uma série que chamamos Pílulas de Conhecimento do IMAM e desta vez estamos aqui nessa bonita vista do Crater Lake lá no Oregon, nos Estados Unidos para tratar de um tema que atuamos sempre junto com um parceiro dentro das empresas que é a Aquarela e o tema desta vez é Data Lake, nada mais sugestivo em função dessa linda paisagem, Data Lake na Supply Chain, ou seja, na cadeia dos suprimentos, então vocês imaginem hoje dentro da visão de Supply a quantidade de informações, a quantidade de dados que a gente dispõe dentro da cadeia de suprimentos, hoje se fala em mais de 500, 4 trilhões de dados ou de informações digitalizadas, então vocês imaginem como lidar com uma quantidade tão grande de informações e obviamente que dentro da cadeia de suprimentos o desafio também é muito grande, seja 4 trilhão, ou 1 bilhão, a gente tem muitos dados aí para serem processados e dentro do supply a gente pode até começar a refletir e identificar puxa vida, dados de demanda, dados de suprimentos, dados de armazenagem, dados da produção, os dados provenientes dos dispositivos IoT que hoje começam a aparecer em grande número no mercado, sejam eles em embalagens, em máquinas, em veículos, os dados financeiros, os dados não estruturados, vindos das redes, das notícias, enfim, quando a gente começa a visualizar esse universo, vocês começam a observar dados provenientes de uma série de fontes dentro da nossa empresa e que se nós não soubermos organizar, se nós não soubermos armazenar isso de uma forma inteligente, em um repositório onde a gente possa acessar essas informações sempre que necessário, nós começamos a, ou devemos ter daqui para frente cada vez mais dificuldades, então hoje nós já falamos em planos diretores para que a gente acesse esses dados dentro das empresas, qualquer projeto que você vai desenvolver hoje de supply de logística demanda dados e a velocidade de nós acessarmos esses dados é que faz a diferença na velocidade também que a gente desenvolve projetos, que a gente toma decisões, que a gente inova, que a gente melhora continuamente as operações e estratégias corporativas. Então, a visão é essa que a gente queria passar, eu vou passar para vocês basicamente sete pontos, por exemplo, começando dentro do universo do supply chain data lake, que supply chain só por meio de times especialistas, hoje não dá para a gente trabalhar com uma pessoa que conheça e se especializou em todas as áreas do supply chain, não existe isso no mundo inteiro, nós precisamos lidar com times, times esses como profissionais especialistas em cada área da supply para que a gente possa ter uma visão sistêmica consistente da nossa cadeia e identificar quais seriam os dados relevantes para que a gente realmente armazene. Que mais, a estruturação dos dados, o significado de cada dados que são as informações de cada informação, ou seja, cada dado tem um conjunto de informação e a gente precisa ter acesso a isso de uma maneira estruturada, dizendo, especificando qual que é o significado de cada dado. Que mais, uma outra preocupação que nós temos que ter na estruturação do data lake, o stack tecnológico adequado, ou seja, uma arquitetura que hoje do ponto de vista de tecnologia está disponível para muitas empresas, mas a gente tem que identificar a que melhor nos atende, cuidado também com as superestimativas do volume de dados. Então tem empresas que, não porque a gente vai trabalhar com muitos dados e estrutura uma arquitetura que vai suportar tão grande quantidade de dados e que se a gente fizer uma análise preliminar pode chegar à conclusão que com pequenas informações a gente pode tomar as mesmas decisões, não haveria necessidade de se armazenar, tamanha quantidade de dados. Cuidado também com o inverso, se existem superestimativas do volume de dados, também existem subestimativas do volume de dados.
Muitos ainda não conseguiram se aperceber da possibilidade da gente estar desenvolvendo muitas soluções e inovações, serviços e produtos a partir dos dados disponíveis. E nem se perceberam de quais dados tem a sua disposição hoje para se trabalhar nessa operação. Analisar a necessidade do uso de índices. Muita gente quando está estruturando o supply chain data lake começa a organizar os dados em índices, gerando um nível, uma quantidade de índices enorme. Nosso parceiro é a Aquarela, o Johnny Hopper, que sempre está conosco, não é destaca. Observe um livro, você observa o índice do livro e veja a quantidade de informação que ele tem. Obviamente que o índice é mais compacto, então sejamos compactos também inteligentes na estruturação do índice dos data lakes. E finalmente manter a segurança. Então obviamente quando a gente fala em dados hoje a gente está falando de segurança e uma das, um dos impactos aí que vai cada vez mais tornar a nossa gestão crítica é a própria LGPD, o que trabalha, ou seja, que está organizando dentro dessa lei geral de proteção de dados para que a gente possa de fato trabalhar com cada vez mais segurança. Então dentro de sete pontos pessoal, são sete aspectos importantes que nós do IMAM e a Aquarela recomendamos quando se está estruturando data lake e voltado a supply chain e esperamos que vocês possam se aprofundar, quem tiver interesse, acesse aqui e saiba mais com esse QR code aí que vocês podem acessar e o artigo completo referente a esse tema que a gente está debatendo hoje. Então queria agradecer desde já essa oportunidade e vamos em frente.
Tá bom pessoal, um abraço e sucesso.
Para aqueles que atuam na Supply Chain e conhecem as “profundezas” dos dados relevantes da Cadeia de Suprimentos, bem como da Logística e da Intralogística, certamente terão no “Data Lake” mais uma oportunidade para avançar em competitividade, principalmente enquanto a maioria das empresas/profissionais ainda não “despertaram”.
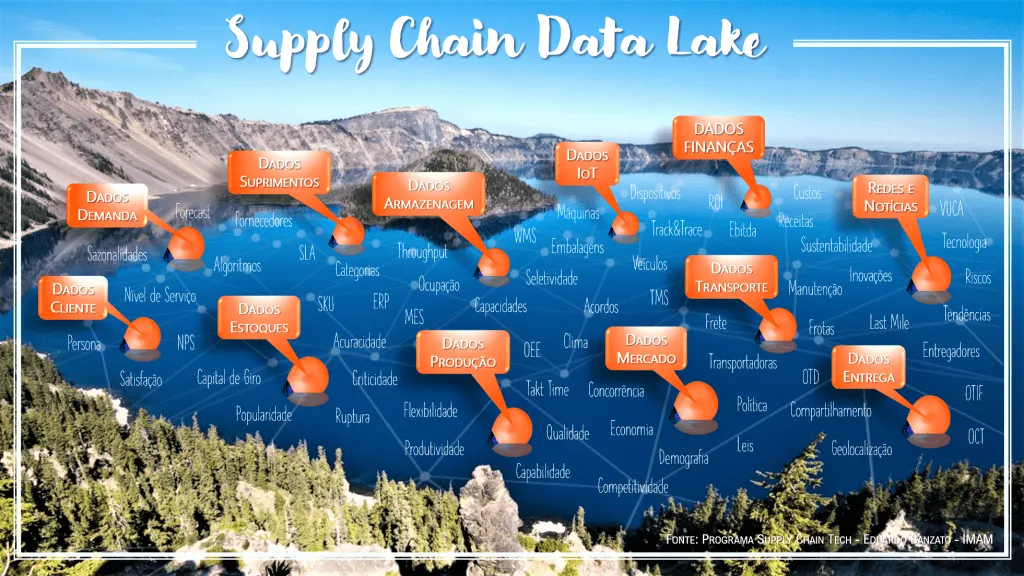
A figura acima não representa a arquitetura de um “Data Lake”, até porque a estrutura de “silos de dados” é mais característica do “Data Warehouse” mas, a ilustração destaca o universo de dados e como podemos explorar projetos de Data Lake, Big Data e Data Analytics aplicados à Cadeia de Suprimentos.
Vale lembrar que a tecnologia, por si só, não fará análises e tomará decisões estratégicas. É a capacidade dos cientistas de dados e dos especialistas de negócios que identificam possíveis dados relevantes que, aí sim, por meio da tecnologia, viabilizam análises e tomadas de decisão baseadas em dados (“data-driven”), bem como contribuem para a automação de decisões mais inteligentes por meio de algoritmos de Inteligência Artificial.
Este contexto tem nos levado, na cadeia de suprimentos, a atuar em times “multiespecializados”, que integram profissionais responsáveis por dados, especialistas de negócios (nas áreas Supply Chain – ex.: IMAM) e profissionais especializados em dados e tecnologia (ex.: Aquarela Analytics, pioneira e referência nacional na aplicação de Inteligência Artificial em empresas como Embraer, Grupo Randon, Solarbr Coca-cola e outros).
Além da necessária inteligência para lidar com dados na Supply Chain, hoje, com o avanço do armazenamento nas nuvens, podemos contar também com praticamente todas as grandes da tecnologia, tais como Google, Oracle, Microsoft, Amazon etc., que oferecem excelentes soluções de “Data Lake”.
Dica de Conteúdo: Anualmente, a IMAM realiza um programa de desenvolvimento profissional, Supply Chain Tech, com empresas de tecnologia aplicada à Supply Chain, pois são os profissionais que farão a diferença nos próximos anos (saiba mais AQUI).
Um “Data Lake” inclui desde os tradicionais dados estruturados, passando pelos dados semiestruturados e os não menos importantes dados não estruturados (vide figura a seguir).
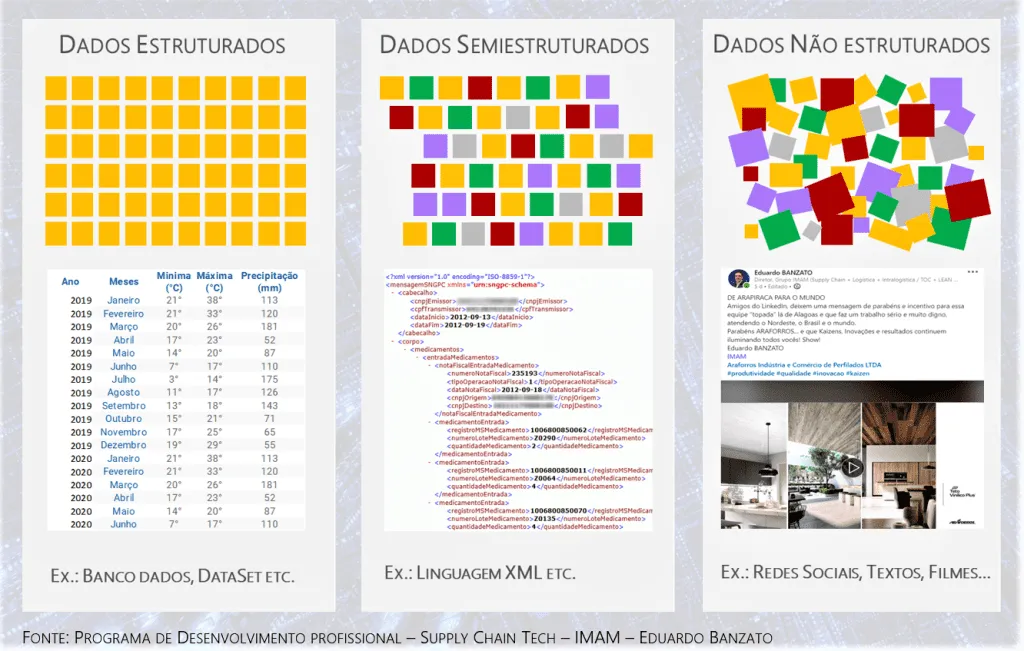
Perceba que os tipos e a quantidade de dados que podemos trabalhar na Supply Chain é muito grande e vale lembrar que a construção destes grandes bancos de dados já é, por si só, um grande desafio técnico. Por outro lado e não menos complexo, está a necessidade de processos coerentes de alinhamento multidisciplinar entre pessoas, processos e o negócio para que o tão esperado “Data Lake” com águas limpas (dados relevantes), não se torne um “Data Swamp” (pântano de dados) repleto de dados com pouco valor prático em tomadas de decisão.
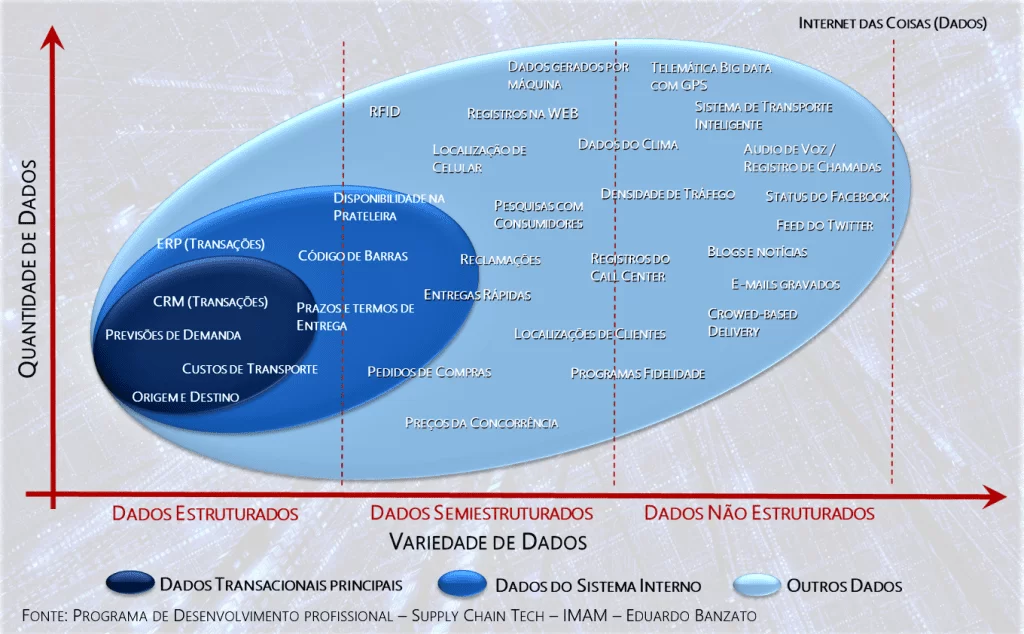
Sim, e é aqui que “separamos o joio do trigo”… É aqui que as equipes mais bem preparadas e os profissionais com visão sistêmica e integrada são fundamentais. Não é uma questão de experiência e/ou juventude mais adaptada à tecnologia. Existem jovens profissionais hoje com habilidades sistêmicas bem desenvolvidas e outros que ainda precisam se desenvolver muito. Ao mesmo tempo, é exatamente isto que acontece com os mais experientes.
Por esse motivo que, no ambiente de Supply Chain, a IMAM e a AQUARELA desenvolvem programas específicos de formação profissional e/ou projetos que exploram exatamente estas carências profissionais na área de Supply Chain/Tecnologia e aproveitamos AQUI para destacar a seguir, na visão de Joni Hoppen e Eduardo Banzato, algumas dicas gerenciais (não tecnológicas), que são pontos de atenção não apenas para os profissionais de Supply Chain, mas principalmente aos gerentes, diretores de tecnologia da informação e CIOs que se envolverão nestes processos de construção e estruturação de “Data Lake” em Supply Chain:
A necessidade de conhecer toda a abrangência do ambiente de negócio que queremos explorar é básica. Hoje, não existe no mercado nacional e/ou mundial, profissionais especialistas em toda a Cadeia de Suprimentos. Isso acontece por um motivo muito simples, a abrangência e os desafios são tão amplos que um profissional, mesmo que dedique sua vida à Supply Chain, não consegue se especializar em todas as suas áreas.
Assim, qual é a solução?
“Precisamos trabalhar em times de especialistas que contribuem com a visão sistêmica e a gestão integrada de toda a Cadeia de Suprimentos”, destaca Eduardo BANZATO.
São os times que promovem “INSIGHTS” e que certamente serão explorados pelos cientistas de dados, iniciando assim projetos que podem ser determinantes para a competitividade na Supply Chain.
A partir de inúmeros projetos de implementação de “Data Lake”, observamos que o principal fator relacionado ao sucesso ou fracasso era a concepção incompleta e até ambígua das análises. Embora o conceito “Lago de Dados” na Supply Chain nos permite guardar os dados como eles são/estão, começar projetos sem uma estratégia clara de negócios não é uma boa. E é aqui que os membros sêniores na equipe, que dominam a cadeia de suprimentos, ajudam a mitigar muito esse tipo de risco.
O grande sucesso dos projetos de analytics geralmente está na estratégia do uso dos dados frente às oportunidades de negócio e não necessariamente na tecnologia envolvida. O foco é no “PORQUÊ” e depois no “COMO”.
Além disso, é fundamental o uso sistemático de metadados (informações sobre os dados).
Uma dica importante para quem está começando a organizar a área de Analytics e “Data Lakes” é começar estruturando os dicionários dados.
É fundamental entender a diferença entre a natureza dos dados transacionais e dados analíticos e os seus papéis/expectativas no projeto.
Embora a tecnologia seja o segundo passo para a estruturação dos lagos de dados, ela é uma das decisões mais importantes a serem tomadas no projeto. A palavra-chave desse processo é a “Arquitetura de sistemas”.
A escolha do “stack” tecnológico, que representa o conjunto de sistemas necessários para executar um único aplicativo sem outro software adicional é base para a criação do “Data Lake” e deve estar alinhado tanto ao “problema” de Supply Chain (negócio) quanto ao conhecimento técnico do time de operação.
Obviamente, desenhar a arquitetura da(s) solução(ões) demanda profissionais com experiência em engenharia de software, bancos de dados, administração e criação de processos de ETL e escalabilidade de infraestruturas de armazenamento.
04 – Cuidado com superestimativas do volume de dados
Assim como no planejamento e construção de um armazém e/ou centro de distribuição, os projetos de estruturação de “lagos de dados” também necessitam de informações básicas e premissas em uma visão de curto, médio e longo prazo (plano diretor).
Entretanto, muitas vezes, essas informações básicas não ficam claras nem para o time de Supply Chain (negócios) e nem para os arquitetos de sistemas, implicando em sub/super estimativa do volume de dados.
Em relação à superestimativa, já nos deparamos com casos onde que se imaginava um conjunto imenso de dados (muito acima da realidade) para se investigar padrões de comportamentos de uma determinada cadeia de suprimentos (indústria), porém, com o passar do tempo, foi verificado que pequenos ajustes na estratégia de indicadores de desempenho, com o uso de técnicas de amostragem, solucionaram, com inteligência e precisão, mais de 80% dos problemas analíticos.
05 – Cuidado com subestimativas do volume de dados
Claro que, do mesmo modo que é possível superestimar, é também possível subestimar o volume de dados.
Por exemplo, existem inúmeras iniciativas na cadeia de suprimentos vindas de outras áreas, com especial ênfase aos projetos de “IoT” (Internet das Coisas) que, na sua natureza, baseiam-se na obtenção do máximo de dados possíveis provenientes de sensores.
Hoje, muitos profissionais têm dificuldades para identificar esta realidade no curto, no médio e principalmente no longo prazo. E isso implica, de fato, em estratégias de armazenamento, compactação, tipos de análise, segurança e ainda velocidade de transmissão.
Outra forma de subestimação de dados é a exploração combinatória dos registros que, em alguns casos, se tornam computacionalmente inviáveis ao processamento e/ou armazenamento. Assim, são imperativas técnicas apropriadas para cada caso e obviamente, um planejamento bem feito.
06 – Analisar a necessidade do uso de Índices
A criação de índices nos bancos de dados deve estar bem estruturada e não descontrolada. O uso de índices em bancos de dados é uma boa prática que visa aumentar a eficiência de consultas muito frequentes. Isso possibilita ao sistema gerenciador de bancos de dados (SGBD) fazer busca de menor complexidade, evitando as custosas buscas sequenciais.
No entanto, índices ocupam espaço, podendo um índice, muito facilmente, chegar a corresponder a 25% do tamanho de uma tabela.
Em “Data Lakes”, o acesso não é repetitivo, não são necessárias consultas de alto desempenho. Portanto, utilizar índices além de chaves primárias para estabelecer as relações entre entidades pode vir a criar volumes desnecessários para atingir uma eficiência não-desejada.
“Lembre-se que nos livros, os índices são bem menores do que o próprio conteúdo”, destaca Joni Hoppen.
07 – Manter a Segurança
É evidente que onde há informação valiosa há também riscos. A segurança requer um nível de maturidade das estruturas de permissões que, por um lado, permitam acesso rápido e fácil aos analistas e máquinas de analytics, sem comprometer regras de acesso que rompam com o sigilo de determinadas informações.
As soluções mais avançadas de governança de dados que conhecemos usam com maestria a teoria da identidade em seus sistemas, não permitindo assim que haja usuários utilizando acessos de terceiros.
Toda a engenharia de software do projeto deve estar em constante comunicação com os times de Supply (gestão e negócio) para garantir o nível correto de permissão de cada usuário a cada dataset (ou conjuntos de dados) que são o principal insumo dos processos de análise de dados e são representados por dados tabulares, em formato de planilha, onde as linhas são os registros dos acontecimentos e as colunas são suas características.
Atualmente, com a entrada em vigor da Lei Geral de Proteção Dados (LGPD), o fator segurança se torna ainda mais crítico, principalmente nos casos em que os dados armazenados são dados pessoais.
As cadeias de suprimentos estão cada vez mais competitivas e, caso sua empresa ainda não percebido, cadeias de suprimentos com mais robustez do ponto de vista de gestão da informação estão se expandindo em um ritmo acelerado (algumas até exponencialmente) e que podem facilmente impactar em absolutamente todos os negócios, inclusive no seu.
Assim, se você e/ou sua empresa já estão conscientes que o poder cada vez mais estará nas mãos daquelas empresas que souberem explorar melhor os dados, considere que:
Desta forma, desejamos sucesso ao seu “Data Lake”, esperando que sua Cultura de Dados avance cada vez mais em direção à competitividade.
Grato pela atenção e vamos em frente!
Eduardo Banzato e Joni Hoppen
O Grupo IMAM é uma organização de consultoria e treinamento que há 40 anos se dedica nos temas de Supply Chain e Gestão Competitiva e a Aquarela Analytics é pioneira e atual referência nacional na aplicação de Inteligência Artificial em diferentes segmentos.
Em resumo, as dicas gerenciais apresentadas no post:
| Dica | O que o post recomenda |
|---|---|
| 1. Times de especialistas | Ninguém domina toda a cadeia; o trabalho exige visão sistêmica e gestão integrada |
| 2. Significado e metadados | Começar pelo porquê, com estratégia clara, dicionário de dados e metadados |
| 3. Stack tecnológico | Arquitetura alinhada ao problema de negócio e ao conhecimento do time |
| 4 e 5. Volume de dados | Evitar superestimar e subestimar, com plano de curto, médio e longo prazo |
| 6 e 7. Índices e segurança | Índices só quando necessários e permissões maduras, ainda mais com a LGPD |
No data lake, os dados ficam armazenados como são, em formato bruto, sem necessidade de estruturá-los, e mesmo assim é possível executar diferentes tipos de análise. No data warehouse, os dados precisam ser estruturados antes, e a organização em silos de dados é mais característica dele. Um banco de dados transacional, por sua vez, atende à operação do dia a dia.
Em geral, ELT. Como o data lake guarda os dados em formato bruto, eles são extraídos e carregados primeiro e transformados depois, conforme a análise que se quer fazer. No data warehouse, o mais comum é o ETL, em que os dados são transformados e estruturados antes da carga.
Especialistas de negócio identificam os dados relevantes da cadeia de suprimentos, da logística e da intralogística, e cientistas de dados, com apoio da tecnologia, viabilizam análises e decisões baseadas em dados. Isso também permite automatizar decisões mais inteligentes com algoritmos de inteligência artificial, sempre a partir de uma estratégia clara de negócio.
É o pântano de dados: um data lake repleto de dados com pouco valor prático para a tomada de decisão. Segundo os autores, ele surge quando faltam processos coerentes de alinhamento multidisciplinar entre pessoas, processos e negócio na construção do lago de dados, e quando o projeto começa sem uma estratégia clara de análise.
Com times de especialistas, já que ninguém domina toda a cadeia de suprimentos sozinho, e com foco primeiro no porquê e depois no como. Os autores recomendam usar metadados de forma sistemática, começar pelos dicionários de dados, entender a diferença entre dados transacionais e analíticos e escolher um stack tecnológico alinhado ao problema de negócio.
Estratégias e Performance (Lean, Toc, 6 Sigma)
Estratégias e Performance (Lean, Toc, 6 Sigma)
Estratégias e Performance (Lean, Toc, 6 Sigma)
O IMAM leva você mais longe!
Acompanhe aqui as principais tendências da área de capacitação profissional, logística e supply chain.